

说明:本文华算科技主要介绍 DFT 在材料计算中长期成为主流方法的原因,包括它的计算对象、精度成本平衡、可输出物理量、数据化能力和适用边界。


一、DFT的基础计算对象是什么?
材料计算最先要确定的是原子结构对应的能量、受力和电子分布。DFT 的优势正在这里:给定晶胞、表面、缺陷或吸附构型后,它能在量子力学框架下求出电子基态,并返回总能、原子力、应力、能带、态密度和电荷密度等结果。结构、能量和电子密度由同一次计算连接起来,这使 DFT 很自然地成为材料研究的基础计算语言。

多个候选晶相、不同缺陷位置、不同表面终止或不同吸附构型,本质上都要比较原子排布改变后的能量和电子分布。DFT 给出的 EDFT、局部电荷、费米能级、功函数和轨道贡献,分别对应稳定性、反应性、输运和界面电子结构。同一套电子结构结果能服务多个判断目标,后续的相稳定、带边位置和吸附强弱才有共同参照。
DFT 还适合处理新材料。经验势和半经验模型往往要先针对一类体系拟合参数,缺少训练区域时外推风险很高;DFT 主要从原子种类、结构和近似泛函出发,不依赖目标材料某个实验性能的拟合曲线。当材料体系还没有足够实验数据时,DFT 常能给出第一批可比较的能量和电子结构基准,候选材料的初筛才不完全依赖经验外推。
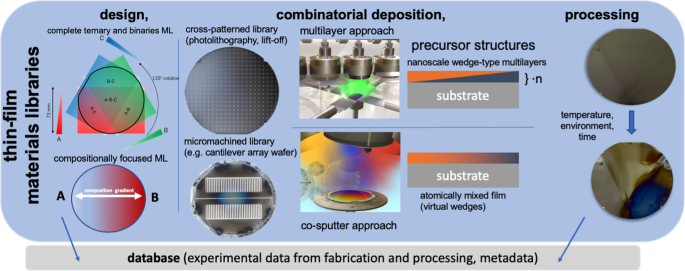
材料空间本身非常大,尤其是多元合金、二维材料、界面和缺陷体系。组合沉积和高通量表征会生成大面积成分梯度,计算端也要有能够快速筛选候选区域的方法。DFT 的角色不是替代实验搜索,而是在巨大候选空间中先建立能量、结构和电子性质的定量坐标,让后续合成和表征少走随机路线。
DFT 数据还能跨项目积累。只要赝势、泛函、k 点、截断能和结构模型有清楚记录,后来者就能复查能量排序、重新计算关键候选,或在同一基准上训练代理模型。可复现的计算设置让 DFT 结果不只是单篇论文中的局部结论,也能进入数据库和自动化筛选流程。
二、为什么DFT能在精度和成本之间保持可用平衡?
精确求解多电子薛定谔方程对真实固体几乎不可承受。高精度波函数方法在小分子中很有价值,但扩展到周期晶体、缺陷超胞和表面 slab 时成本迅速升高。经验模型速度快,却常把电子重排、价态变化和成键竞争压缩进拟合参数。DFT 位于两者之间:保留电子结构描述,又把计算成本压到可用于实际材料模型的范围。
这个平衡来自交换相关泛函的近似。LDA、GGA、PBEsol、SCAN、DFT+U、HSE 和 GW 等方法对应不同成本和电子结构层级。半局域泛函适合大量结构优化、形成能和趋势筛选;混合泛函或 GW 更适合校正带隙、带边和激发相关性质。常用不等于固定使用同一个泛函,目标性质决定应停在半局域泛函、DFT+U、混合泛函还是准粒子修正。

带隙偏小通常指向交换相关泛函的限制;形成能排序对元素类型敏感时,参考态、U 值和化学势会成为主要误差来源;表面能变化不收敛时,slab 厚度、真空层和 k 点采样要回到同一收敛标准。误差来源能够拆分到泛函、模型和数值采样条件,DFT 才适合承担可复查的材料计算基准。
在实际材料计算中,DFT 的成本还可以通过工作流分配。粗筛阶段用较便宜的泛函和较小模型找出候选区域,精筛阶段再提高 k 点密度、截断能、超胞尺寸或泛函层级。这种分层计算方式让 DFT 既能处理几千个候选结构,也能对少数关键体系做更细的电子结构核查。
高通量筛选和贝叶斯优化中的多保真策略也反映了同一个事实:低成本模型负责快速缩小搜索区域,高成本计算负责确认候选结果。DFT 常处在高可信计算的核心位置,也会成为机器学习势、代理模型和实验筛选的参照数据。它不是成本最低的方法,却常是成本仍可承担、物理含义又足够清楚的基准方法。

三、DFT为什么能覆盖材料研究中的主要对象?
材料研究中的对象并不只是一块理想体相晶体。晶界、表面、异质界面、吸附物、溶剂层、掺杂原子和空位都会改变局部电子结构,体相、表面和界面共用能量-力-电子密度语言。DFT 的常用性来自它能把这些对象统一写成原子坐标和边界条件,再通过能量、力和电子密度进行比较。同一形式的计算模型可以在体相、低维、表面和界面之间迁移,不同材料对象由能量、力和电子密度这组共同变量串联。
在表面和界面模型中,DFT slab 计算可以得到真空能级、表面偶极、平面平均 Hartree 势、价带顶和导带底位置。由这些量出发,研究者能估计功函数、电子亲和能、离子化势和带边对齐。这些输出把原子尺度界面结构和宏观器件中的能级匹配联系起来,光催化、光伏、电池和电催化界面研究都能沿这类能级参照展开。

不同 Miller 指数和表面终止可以从体相结构批量生成,再构造 slab、弛豫原子位置,随后计算表面能、能带、DOS、Bader 电荷或功函数。自动化表面工作流在固定模型规则后,能把大量可能表面转化为可排序、可追溯的 DFT 任务。

同一组表面结构可以同步输出表面能随化学势变化的曲线、欠配位程度、带隙和电荷积累。能量排序、局部配位和电子性质分别描述热力学稳定、局部成键缺失和电子响应,材料计算才有条件把“哪个表面更稳定”和“哪个表面更适合电子发射或吸附反应”区分开来。

四、最常用是否等于所有材料问题都适合用DFT?
DFT 的主流地位来自可用平衡,并非来自完美。半局域泛函对带隙、长程色散、强关联 d/f 电子、激发态和电荷局域化存在偏差;有限温度、长时间扩散、复杂液固界面和大尺度无序结构也会让常规静态 DFT 变得吃力。DFT 适合建立原子尺度基准,但基准必须写明泛函、模型、收敛条件和目标性质。
对于带隙和带边,可在 PBE 基础上加入 HSE、GW 或 BSE;对于层状材料和分子吸附,可加入 vdW 修正;对于过渡金属氧化物,可比较 DFT+U、自旋态和磁矩;对于扩散和热稳定,可引入 AIMD、声子自由能或机器学习势。方法补强应围绕目标物理量展开,高成本计算仍要接受结构、能量和实验趋势的交叉校验。
DFT 也常与实验高通量表征配合使用。计算给出候选成分、相稳定性和电子结构趋势,材料库实验给出真实合成窗口、相组成、结构和功能性质。两类数据在同一数据库中积累后,研究者可以反复校验模型假设、修正筛选条件,并把候选材料压缩到可实验验证的范围。常用方法的价值在于形成可复查的计算数据,实验相组成、缺陷浓度和实际服役环境仍会继续限制计算结论。

在数据库和自动化研究中,DFT 结果还承担“共同坐标系”的功能。不同课题可以共享能量、结构、磁矩、带隙、体模量、声子频率和吸附能等字段,机器学习模型也常以这些字段作为训练目标。数据字段稳定、物理含义明确、计算流程可追踪,是 DFT 能持续留在材料计算中心位置的现实原因。
DFT 在材料计算中最常用,是因为它把可接受的量子精度、可承担的计算规模、可解释的电子结构和可积累的数据格式放到同一个方法体系里。明确模型边界后,DFT 能给出结构稳定、界面能级、吸附强弱、带隙趋势和局部电荷分布的共同参照;当体系进入强关联、激发态、长时间动力学或复杂环境时,修正方法、动力学模拟和实验数据会继续限定这些参照的适用范围。
